RTX 5090, DGX Spark o Mac Studio: qué máquina elegir para correr IA en local
Por Kike Gandia · IA y Seguridad · 10 min de lectura
Cada vez más empresas quieren un modelo de lenguaje que trabaje con sus contratos, su código o sus historiales sin que nada salga del edificio. En 2026 hay tres formas obvias de montarlo sobre una mesa: una NVIDIA GeForce RTX 5090 en un PC, una NVIDIA DGX Spark o un Mac Studio con M5 Ultra. Las tres cuestan miles de euros y las tres se anuncian como la máquina para la IA local.
Comparadas por TFLOPS, no hay forma de decidir: cada fabricante elige la precisión y el escenario que más le favorecen. Para generar texto con un LLM importan dos números, y los dos están en la ficha técnica: cuánta memoria rápida tiene la máquina y a qué velocidad la lee. El primero decide qué modelos podéis cargar. El segundo, a qué velocidad os responden.
- 32 GB · 1.792 GB/s
- RTX 5090 (GDDR7, la más rápida y la más pequeña)
- 128 GB · 273 GB/s
- DGX Spark (LPDDR5X unificada, cuatro veces más memoria)
- 256 GB · 1,2 TB/s
- Mac Studio M5 Ultra (unificada; 512 GB anunciados)
La única cuenta que importa
Un modelo de lenguaje genera texto token a token, y para cada token tiene que leer de memoria todos sus pesos activos. Si el modelo ocupa 20 GB, cada palabra que escribe obliga a mover 20 GB desde la memoria hasta las unidades de cálculo. Casi siempre el cálculo espera a la memoria, no al revés.
El techo de velocidad. Tokens por segundo como máximo = ancho de banda de memoria ÷ GB que se leen por token. Un modelo de 19,8 GB en una RTX 5090 (1.792 GB/s) no puede pasar de unos 91 tok/s; en una DGX Spark (273 GB/s), de unos 14. En la práctica llama.cpp, MLX o vLLM se quedan entre el 55 % y el 75 % de ese techo.
Hay dos matices que lo cambian todo. El primero: si el modelo no cabe, la cuenta deja de valer. En una 5090, lo que no entra en sus 32 GB baja a la RAM del PC, que se lee a unos 90 GB/s (DDR5 de doble canal), veinte veces más despacio. En la Spark y el Mac no hay a dónde bajar: o cabe, o no arranca. El segundo: los modelos de mezcla de expertos (MoE), como gpt-oss-120b o Qwen3 235B, ocupan mucho pero en cada token solo leen una fracción. Ocupan como un modelo grande y van a la velocidad de uno pequeño.
El banco de tolvas: las tres máquinas con el mismo modelo
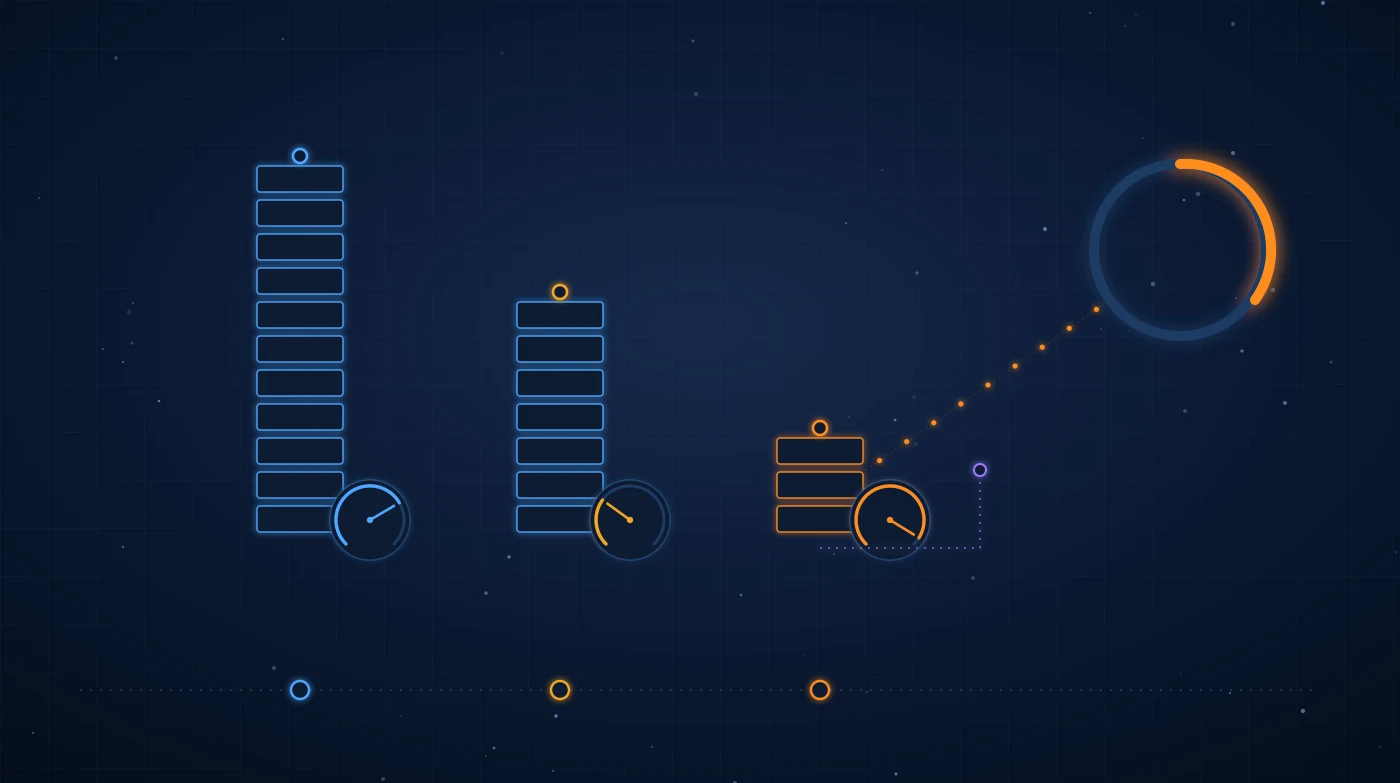
La figura convierte esa cuenta en una máquina que se puede mirar. Cada tolva es un ordenador: su altura es su memoria y el ancho de la canaleta por la que se vacía es su ancho de banda. Al elegir un modelo, el tubo de nivel de cada tolva se llena con sus pesos y la esfera marca el techo de tokens por segundo. A la derecha de la 5090 está la RAM del PC que la aloja, unida a ella por un conducto mucho más fino: es por donde pasa lo que no cabe en la tarjeta.
Figura interactiva «banco de tolvas». Tres tolvas sobre una bancada representan tres máquinas: un Mac Studio M5 Ultra con 256 GB de memoria unificada a 1,2 TB/s, una NVIDIA DGX Spark con 128 GB a 273 GB/s y una RTX 5090 con 32 GB de GDDR7 a 1.792 GB/s, acompañada de la RAM del PC (128 GB de DDR5 a unos 90 GB/s). La altura de cada tolva es su memoria y el ancho de su canaleta, su ancho de banda. Al elegir un modelo (Llama 3.1 8B, Qwen3 32B, Llama 3.3 70B, gpt-oss-120b o Qwen3 235B-A22B), cada tolva se llena con sus pesos y una esfera logarítmica marca el techo teórico de tokens por segundo: ancho de banda dividido por los GB que se leen por token. Si el modelo no cabe, se enciende un piloto rojo; en la 5090, lo que no cabe se desborda a la RAM del PC. Los valores de la figura son los de la tabla siguiente.
Techo teórico de generación (tokens/s), sin caché KV
| Modelo (cuantización) | Ocupa / lee por token | Mac Studio M5 Ultra | DGX Spark | RTX 5090 + RAM |
|---|---|---|---|---|
| Llama 3.1 8B (Q4_K_M) | 4,9 GB / 4,9 GB | 245 | 56 | 366 |
| Qwen3 32B (Q4_K_M) | 19,8 GB / 19,8 GB | 61 | 13,8 | 91 |
| Llama 3.3 70B (Q4_K_M) | 42,5 GB / 42,5 GB | 28 | 6,4 | 7,4 (10,5 GB en RAM) |
| gpt-oss-120b (MXFP4, MoE) | 63 GB / 2,8 GB | 429 | 98 | 62 (31 GB en RAM) |
| Qwen3 235B-A22B (Q4_K_M, MoE) | 142 GB / 13,2 GB | 91 | No cabe | 8,7 (110 GB en RAM) |
Las mediciones publicadas encajan con estos techos. Con llama.cpp bien configurado, la DGX Spark ronda los 60 tok/s con gpt-oss-120b (un 62 % del techo) y se queda en 4-7 tok/s con modelos densos de 70 B. Una 5090 genera en torno a 60 tok/s con un 32 B denso a 4 bits (dos tercios del techo) y cae a un dígito en cuanto un modelo denso se le sale de la VRAM. La tabla no sirve para predecir la cifra exacta de vuestro caso; sirve para saber qué orden de magnitud esperar antes de comprar.
Cada máquina, en una frase
- RTX 5090 La más rápida, mientras el modelo quepa
- Con 1.792 GB/s no tiene rival en modelos de hasta unos 30 GB, y el procesado del prompt (prefill) es varias veces más rápido que en las otras dos. Su límite son los 32 GB: un 70 B denso ya no cabe y se arrastra. Para MoE grandes, descargar los expertos a la RAM del PC funciona sorprendentemente bien.
- DGX Spark Mucha memoria, poca velocidad de lectura
- 128 GB permiten cargar casi cualquier modelo abierto, pero sus 273 GB/s la hacen lenta con modelos densos grandes. Brilla con MoE (gpt-oss-120b), con el ecosistema CUDA completo, con ajuste fino y con FP4. Dos unidades se unen por su red ConnectX-7 para sumar 256 GB.
- Mac Studio Capacidad y velocidad a la vez, a precio de las dos
- Es la única de las tres que combina mucha memoria con mucho ancho de banda: 256 GB a 1,2 TB/s, con 512 GB anunciados. Es silenciosa y consume poco. A cambio, se queda fuera de CUDA (se trabaja con MLX o llama.cpp con Metal) y es la más cara con diferencia.
Lo que la tabla no dice
- Leer el prompt no es lo mismo que escribir. Procesar un documento largo antes de responder (prefill) depende del cálculo, no de la memoria. Ahí la 5090 gana con holgura a las otras dos: si vuestro uso es resumir contratos de 80 páginas, el tiempo hasta la primera palabra pesa más que los tokens por segundo.
- El contexto también ocupa memoria. La caché KV de una conversación larga puede sumar decenas de GB. Un modelo que cabe justo con 4.000 tokens de contexto deja de caber con 100.000.
- El software decide la mitad del resultado. CUDA tiene vLLM, TensorRT-LLM y casi todo el ecosistema de ajuste fino; el Mac tiene MLX y llama.cpp. Una actualización de firmware o de llama.cpp ha movido las cifras de la Spark más de un 20 % en un año.
- Consumo y ruido. La 5090 sola puede consumir 575 W en un PC de torre; la Spark cabe en la palma de la mano y el Mac Studio apenas se oye. Para una máquina que va a estar encendida en una oficina, cuenta.
- Concurrencia. Las cifras son para un usuario. Si vais a servir a un equipo entero, el cálculo pasa a ser de lotes y de memoria para varias cachés KV a la vez, y la conversación es otra.
Cuánto cuestan (octubre de 2026)
Los precios de memoria se han disparado en 2026 y los de las tres máquinas han subido varias veces en pocos meses. Tomad estas cifras como orientación y comprobad la tienda del fabricante antes de comprar.
| Máquina | Precio de referencia | Qué incluye |
|---|---|---|
| RTX 5090 | De 2.500 a 6.000 € en tiendas españolas, según modelo y semana | Solo la tarjeta: hace falta un PC a su altura, y 128 GB de DDR5 cuestan hoy bastante más que hace un año |
| DGX Spark | 4.699 $ de precio oficial desde febrero de 2026; unos 4.600-4.800 € en la UE | El equipo completo con 128 GB y 4 TB. Circulan informes de nuevas subidas en octubre aún sin confirmar en la tienda de NVIDIA |
| Mac Studio M5 Ultra | Desde unos 6.600 € con 96 GB (precio europeo); con 256 GB, unos 11.000 € | El equipo completo. La configuración de 512 GB está anunciada sin precio |
Cuál elegir
- 1 — Decidid primero el modelo, no la máquina
Qué modelo necesitáis y con cuánto contexto. Eso fija los GB que tienen que caber. Todo lo demás viene después. - 2 — Hasta ~30 GB: RTX 5090
Modelos de 8 a 32 B, asistentes de código, RAG sobre documentación interna. Es la opción más rápida y, con un PC que ya tengáis, la más barata. - 3 — MoE grandes y desarrollo en CUDA: DGX Spark
gpt-oss-120b y similares a velocidad útil, el mismo software que correrá luego en un servidor DGX y la posibilidad de afinar modelos. Evitadla si vais a usar modelos densos de 70 B o más. - 4 — Modelos enormes o densos grandes: Mac Studio
Si necesitáis un 70 B denso con soltura o un MoE de más de 128 GB en una sola caja, es la única de las tres que lo hace sin desbordar a una memoria lenta.
Local no significa seguro
La razón por la que muchas empresas miran estas máquinas es de seguridad: que los datos personales, los secretos industriales o el código no lleguen a un proveedor de IA en la nube. Es un buen motivo, y simplifica mucho la parte del RGPD. Pero cambiar la nube por una máquina en la oficina no elimina el riesgo, solo lo traslada a algo que ahora gestionáis vosotros.
- Red Servidores de inferencia abiertos
- Ollama, LM Studio o vLLM escuchan en un puerto HTTP que por defecto no pide autenticación. Expuesto a la red de la oficina, o peor, a internet, cualquiera puede usar el modelo, leer lo que otros le pasan o cargar otro.
- Modelos Pesos de origen dudoso
- Un modelo descargado de un repositorio público es software de terceros. Formatos antiguos basados en pickle ejecutan código al cargarse, y un modelo ajustado por un desconocido puede venir con puertas traseras de comportamiento.
- Datos Lo que el modelo puede ver
- Un RAG o un agente local con acceso a toda la carpeta compartida responde a quien pregunte lo que haya dentro. Los permisos de los documentos tienen que llegar hasta el modelo.
- Registro Sin trazas no hay investigación
- Si nadie registra quién preguntó qué, el día que algo se filtre no habrá forma de saber cómo. Una IA local necesita los mismos registros que cualquier otro servicio interno.
Si estáis montando un asistente sobre una de estas máquinas, merece la pena decidir antes qué datos pueden entrar (¿esto puedo subírselo a la IA?) y qué herramienta lo sirve (Docker Model Runner frente a Ollama). Y cuando esté funcionando, probarlo como lo haría un atacante: es lo que hacemos en el pentesting de aplicaciones de IA y dentro de nuestro servicio de uso seguro de la IA en la empresa.
Servicio relacionado
uso seguro de la IA en la empresa
Temas de este artículo
#IA-local #LLM #RTX-5090 #DGX-Spark #Mac-Studio #Apple-Silicon #llama-cpp #Ollama #Hardware #Soberanía-del-dato
Seguir leyendo
- Así se ataca una aplicación con IA: inyección de prompts y agentes con herramientas
- Jev y los modelos System 1: cuando la IA deja de escribir y empieza a decidir
- Implantar IA en la empresa sin abrir un agujero: control, gobernanza y medición
- Biocomputación Humana: Seguridad e Inteligencia Organoide en la Nueva Era de la IA
- Transformando Sectores con IA, Automatización y Ciberseguridad
Fuentes
- NVIDIA — DGX Spark: especificaciones (GB10, 128 GB LPDDR5X, 273 GB/s)
- NVIDIA — GeForce RTX 5090: especificaciones (32 GB GDDR7)
- Apple — Mac Studio: especificaciones técnicas
- TechPowerUp — NVIDIA sube el precio de DGX Spark a 4.699 dólares (febrero de 2026)
- Engadget — Análisis del Mac Studio con M5 Ultra
- Geeknetic — El precio medio de la RTX 5090 en España
- llama.cpp — Proyecto y comparativas de rendimiento de la comunidad