Anatomía de 0data: diseccionamos una plataforma de datos e IA que no sale de tu casa
Por Kike Gandia · IA y Seguridad · 13 min de lectura
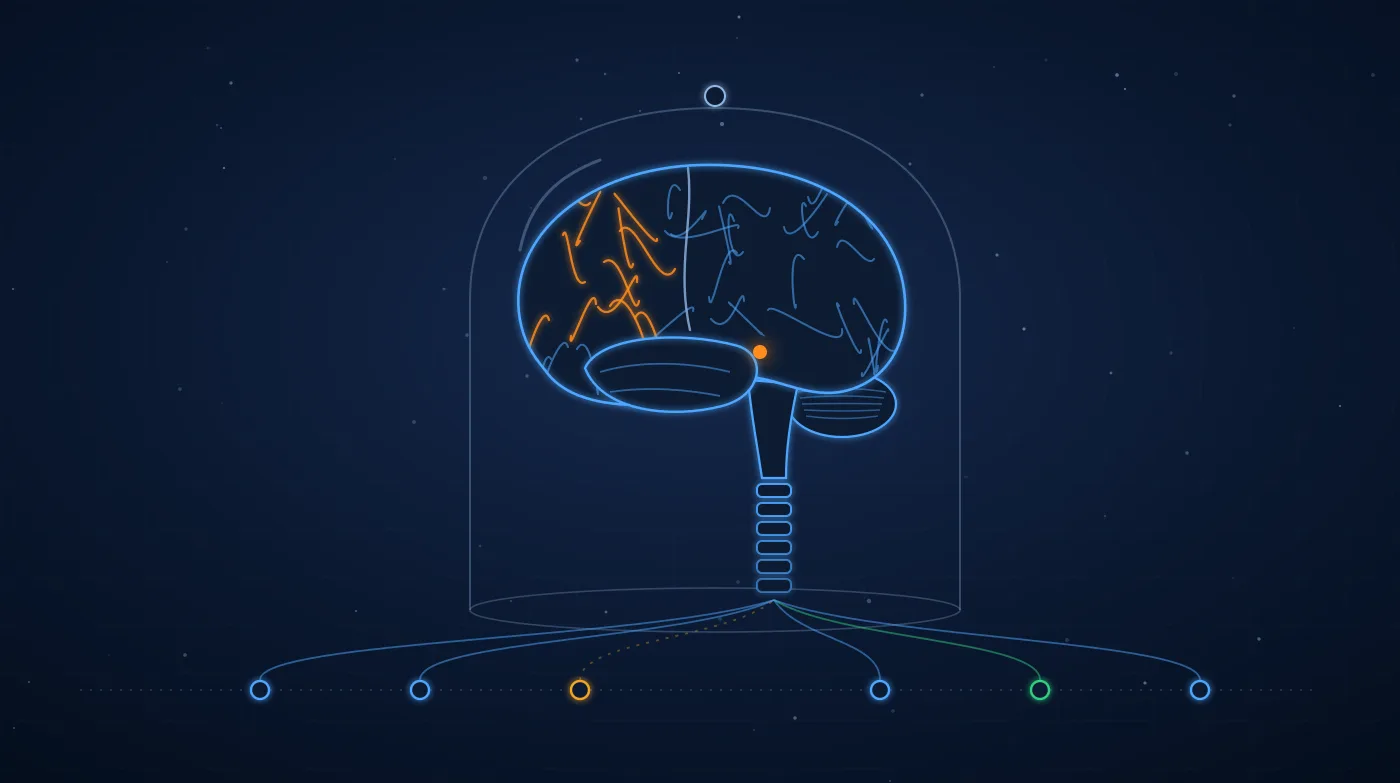
Hay empresas que llevan dos años «haciendo un proyecto de IA» y otras que lo tienen parado en el comité de seguridad. Casi nunca es porque falte un modelo mejor. Es porque la IA es la última pieza de una cadena, y las piezas de antes —los datos, el aprendizaje, el control— no están.
0data es la plataforma de QuantumSec que resuelve esa cadena entera dentro de vuestra infraestructura. Para explicarla no vamos a dibujar cajas con flechas: la vamos a abrir como se abre un cerebro en una mesa de laboratorio, capa a capa, y en cada capa veréis qué hace y por qué está ahí.
- +570
- fuentes configuradas (boletines, registros, mercados, prensa…)
- +200
- flujos automáticos (cada uno a su ritmo)
- 100s M
- documentos en la plataforma (cientos de millones, hoy)
- 0
- datos que salen de vuestra casa (puede funcionar sin internet)
Seis síntomas de que el problema no es la IA
La mayoría de empresas no tiene un problema de inteligencia artificial: tiene cuatro problemas encadenados —datos, modelos, aprendizaje y control— y la IA solo funciona cuando se resuelven a la vez. Se reconocen por estas frases.
- Datos «Nos enteramos tarde»
- El dato estaba publicado: en un boletín, en la web del regulador, en un registro, en la prensa local. Faltaba alguien mirando todos los días, en todas las fuentes, sabiendo qué buscar.
- Datos «Tenemos los datos, pero no los podemos usar»
- Hojas de cálculo, ERP, CRM, PDFs escaneados y carpetas compartidas, cada uno en su formato. Cada proyecto de IA empieza de cero limpiando datos.
- Control «No podemos mandar esto a un modelo de fuera»
- Banca, salud, legal, industria, sector público: el caso de uso está claro y muere en el comité, por una razón legítima.
- Modelos «La IA genérica no entiende nuestro negocio»
- No sabe qué significa cada código de vuestro ERP ni cómo se redacta un aviso en vuestro sector. Se equivoca con seguridad, y cada consulta se paga.
- Aprendizaje «El panel está en verde y los datos están rotos»
- El fallo más caro, porque no se nota: un proceso termina «bien» cada noche y lleva semanas sin traer nada.
- Control «Nadie sabe de dónde sale esta cifra»
- Un informe dice 1,2 millones. ¿De qué fuente, de qué fecha, qué transformación, qué modelo la tocó? Sin linaje no hay confianza.
Las seis frases que más oímos. Cada una es un síntoma de una de las cuatro capas que siguen.
La disección, capa a capa
Bajad despacio. La figura se queda arriba y el cerebro se va abriendo con el texto: primero entra el dato por los nervios, después se aparta un hemisferio para ver el tálamo y los lóbulos, luego sale el cerebelo y, al final, la campana vuelve a cerrarse. Podéis saltar a cualquier etapa con las pestañas.
Figura interactiva: un cerebro de laboratorio bajo campana que se disecciona en cinco etapas. 00, el espécimen: una plataforma con cuatro capas (datos, modelos, aprendizaje y gobernanza) instalada en vuestro servidor. 01, datos: más de 570 fuentes configuradas y más de 200 flujos automáticos (boletines, registros mercantiles, mercados, prensa, ciberseguridad, datos abiertos), más vuestros datos internos con OCR; texto completo, búsqueda vectorial, grafo de relaciones, almacenamiento relacional y de objetos con cientos de millones de documentos; captura distribuida en nodos propios; cada fuente medida contra su propio ritmo, porque una llegó a estar 67 días vacía con su proceso en verde. 02, modelos: un enrutador elige el modelo según la pregunta y el coste; modelos de lenguaje locales (o comerciales con vuestras claves), clasificación sin entrenamiento previo, modelos de decisión con probabilidad calibrada, predicción de series temporales, visión y extracción de entidades; cada nombre, cifra y porcentaje de un informe se contrasta con los datos de origen. 03, aprendizaje: cada aviso es una predicción comprobable y el sistema recalibra sus umbrales con vuestro histórico; entrenamiento de modelos propios con vuestros datos (en beta); autonomía que se gana con resultados. 04, gobernanza: instalación en vuestro servidor y funcionamiento sin internet si hace falta; datos personales detectados y pseudonimizados antes de llegar a un modelo, con el valor real en un almacén cifrado aparte; aislamiento entre organizaciones que falla cerrado; control de acceso granular; auditoría encadenada criptográficamente y sellable en almacenamiento inmutable; linaje y catálogo; aprobación humana de lo que tiene consecuencias; y un panel que dice «sin respuesta» en vez de «0» cuando no pudo preguntar.
El fallo más caro es el que no se nota
Lo aprendimos en nuestra propia plataforma. Una fuente de mercados llevaba 67 días sin traer un solo documento mientras su proceso terminaba en verde cada tres horas: más de quinientas ejecuciones «correctas» seguidas. Nadie se enteró, porque todo lo que se vigilaba era si el proceso acababa bien, no si traía lo que tenía que traer.
Gráfico interactivo de 90 días de una fuente: durante 23 días trae entre 40 y 140 documentos diarios con su ritmo semanal; desde el día 24 no trae ninguno durante 67 días, mientras las ocho ejecuciones diarias del proceso (536 en total) siguen en verde. Si solo se vigila el proceso, el panel no avisa nunca; si se vigila también el ritmo propio de la fuente, el aviso salta a las seis horas del primer día sin datos.
Desde entonces la plataforma vigila también a sus propias fuentes, y cada una contra su ritmo, no contra un umbral genérico: un proceso semanal no salta cada martes y uno que escribe cada hora no pasa desapercibido cuando se para. La cobertura, además, se publica: qué falta, desde cuándo y por qué.
Un panel nunca dice cero cuando no ha podido preguntar. Si una comprobación falla, la pantalla dice «sin respuesta», no «0 incidencias». Parece un detalle. Es la diferencia entre un sistema en el que se puede confiar y uno que tranquiliza mientras algo se rompe.
Lo que le pasa a un dato personal antes de llegar a un modelo
Es la pregunta que decide los comités de seguridad. La respuesta es una barrera que todo mensaje y todo documento cruza antes de que lo lea un modelo de IA, sea local o externo.
- 1 — Entra el texto
Un correo de un cliente, un expediente, una incidencia o una pregunta al asistente. - 2 — Se buscan datos personales
DNIs, cuentas bancarias, teléfonos y demás identificadores, antes de que el texto vaya a ningún sitio. - 3 — Se aplica la política del usuario
Bloquear el envío, avisar o pseudonimizar. La decide la organización, no el modelo. - 4 — El modelo ve un código
Donde ponía el DNI, el modelo lee «[DNI_a1b2]». Puede razonar con él, pero no conoce el valor. - 5 — El valor real se guarda aparte
En un almacén cifrado y separado que solo se abre con su propia llave. - 6 — Queda en la cadena de auditoría
Cada paso relevante va a un registro encadenado: cada entrada depende de la anterior y alterar una rompe la cadena.
Lo que llega al modelo pseudonimizado
- El cliente [DNI_a1b2] reclama el cargo del día 3.
- Su cuenta [IBAN_7f3c] tiene dos devoluciones.
- Contactar en [TEL_09de].
Lo que queda en el almacén cifrado, con su propia llave
- [DNI_a1b2] → el documento real del cliente.
- [IBAN_7f3c] → la cuenta real.
- [TEL_09de] → el teléfono real.
El modelo puede responder igual de bien; lo que no puede es filtrar lo que nunca vio.
Y encima, lo que usa vuestro equipo
Sobre las cuatro capas trabaja la parte que se ve cada día. No hace falta saber nada de lo que hay debajo para usarla.
- Móvil Avisos con contexto
- Cuando algo se sale de lo normal para vosotros, con la recomendación y la fuente original.
- Chat Preguntas en lenguaje normal
- Sobre todos vuestros datos, con la fuente de cada respuesta.
- Agentes Análisis por su cuenta
- Cuando detectan un hueco, investigan y os presentan conclusiones, no listados.
- Sectores Aplicaciones listas
- Vigilancia de competencia y de marca, ciberseguridad para empresas sin equipo de seguridad, seguimiento normativo, riesgo de mercado y geopolítico, salas de situación, predicción de demanda.
- API Para vuestros sistemas
- Claves acotadas y avisos automáticos (webhooks) para que datos y alertas lleguen a vuestras herramientas.
En qué se diferencia de una plataforma tradicional
| Plataformas tradicionales | 0data | |
|---|---|---|
| Dónde viven vuestros datos | En su nube | En vuestro servidor, incluso sin internet |
| Modelos de IA | Alquilados y genéricos | Locales, especializados con vuestros datos, vuestros |
| Tiempo hasta el primer resultado | Meses o años | Semanas |
| ¿Sabe si acierta? | No | Mide cada predicción y se recalibra |
| Control | Configurado una vez | Auditoría encadenada, linaje y aprobación humana |
| Fuentes externas | Las integráis vosotros | Más de 570 ya en marcha |
¿Y frente a usar ChatGPT o Copilot? Esos contestan cuando les preguntáis, con un modelo que no es vuestro y sobre datos que salen de casa. 0data vigila cuando no estáis preguntando, trabaja sobre vuestros datos dentro de vuestra infraestructura y puede usar modelos entrenados por vosotros. Si os preocupa el hardware, en qué máquina elegir para correr IA en local lo explicamos con números.
Cómo empezamos: un caso, seis semanas, precio cerrado
- Semana 0 — Una conversación
Nos contáis la última vez que os enterasteis tarde de algo que os costó dinero, o el proyecto de IA que tenéis parado por privacidad. Ese es el caso. - Semanas 1-6 — Lo montamos en vuestra infraestructura
Con vuestras fuentes y vuestros datos reales, no con una demo. - Semana 6 — Lo medimos juntos
Sin porcentajes de folleto: qué avisos llegaron, cuáles acertaron y cuánto trabajo os habéis ahorrado.
La plataforma ya está construida. Lo que hacemos con vosotros es vuestro caso; después vienen el siguiente y el siguiente, sobre la misma base.
Preguntas frecuentes
¿Necesitamos GPU o un centro de datos?
No para empezar. Muchos casos funcionan en un servidor estándar. El hardware dedicado solo hace falta para entrenar modelos propios o para cargas grandes, y os lo dimensionamos antes.
Ya tenemos un data lake o Power BI.
Lo aprovechamos. 0data se conecta a lo que ya tenéis, añade lo de fuera, la IA y el control, y os avisa si los datos de vuestro cuadro de mando han dejado de llegar.
¿Cómo cumplimos con el RGPD y con nuestro comité de seguridad?
Con los datos en vuestro servidor, pseudonimización antes de cualquier modelo, control de acceso por usuario y una auditoría encadenada de cada acción. Os preparamos la documentación para el comité. Si además estáis redactando las normas internas, os sirve nuestra guía de política de uso de IA en la empresa.
¿La IA se inventa cosas?
Cada cifra y cada nombre de un informe se contrasta con los datos de origen antes de enseñároslo. Si no hay fuente, no hay afirmación.
¿Podemos entrenar un modelo con nuestros datos?
Sí: desde la propia plataforma se construye el conjunto de entrenamiento con vuestros datos ya etiquetados y se especializa un modelo abierto que queda instalado en vuestra máquina. Es una función en beta; os diremos con franqueza si vuestro caso la necesita o si basta con lo demás.
No tenemos equipo técnico.
No hace falta. Los avisos llegan al móvil en lenguaje normal; la parte técnica es nuestra. Y como somos una empresa de seguridad ofensiva, la plataforma pasa por las mismas pruebas que hacemos en el pentesting de aplicaciones con IA.
¿Con qué caso empezaríais vosotros? Tenéis todo el detalle en la página de 0data, o escribidnos: si nos decís vuestro sector, os mandamos antes uno de nuestros informes públicos hecho con la propia plataforma, para que veáis lo que produce antes de hablar.
Servicio relacionado
Temas de este artículo
#0data #Plataforma-de-datos #IA-local #Soberanía-del-dato #LLM #Fine-tuning #Pseudonimización #Auditoría #Gobernanza-del-dato #RGPD
Seguir leyendo
- RTX 5090, DGX Spark o Mac Studio: qué máquina elegir para correr IA en local
- Así se ataca una aplicación con IA: inyección de prompts y agentes con herramientas
- Jev y los modelos System 1: cuando la IA deja de escribir y empieza a decidir
- Biocomputación Humana: Seguridad e Inteligencia Organoide en la Nueva Era de la IA
- Transformando Sectores con IA, Automatización y Ciberseguridad