Jev y los modelos System 1: cuando la IA deja de escribir y empieza a decidir
Por Kike Gandia · IA y Seguridad · 14 min de lectura
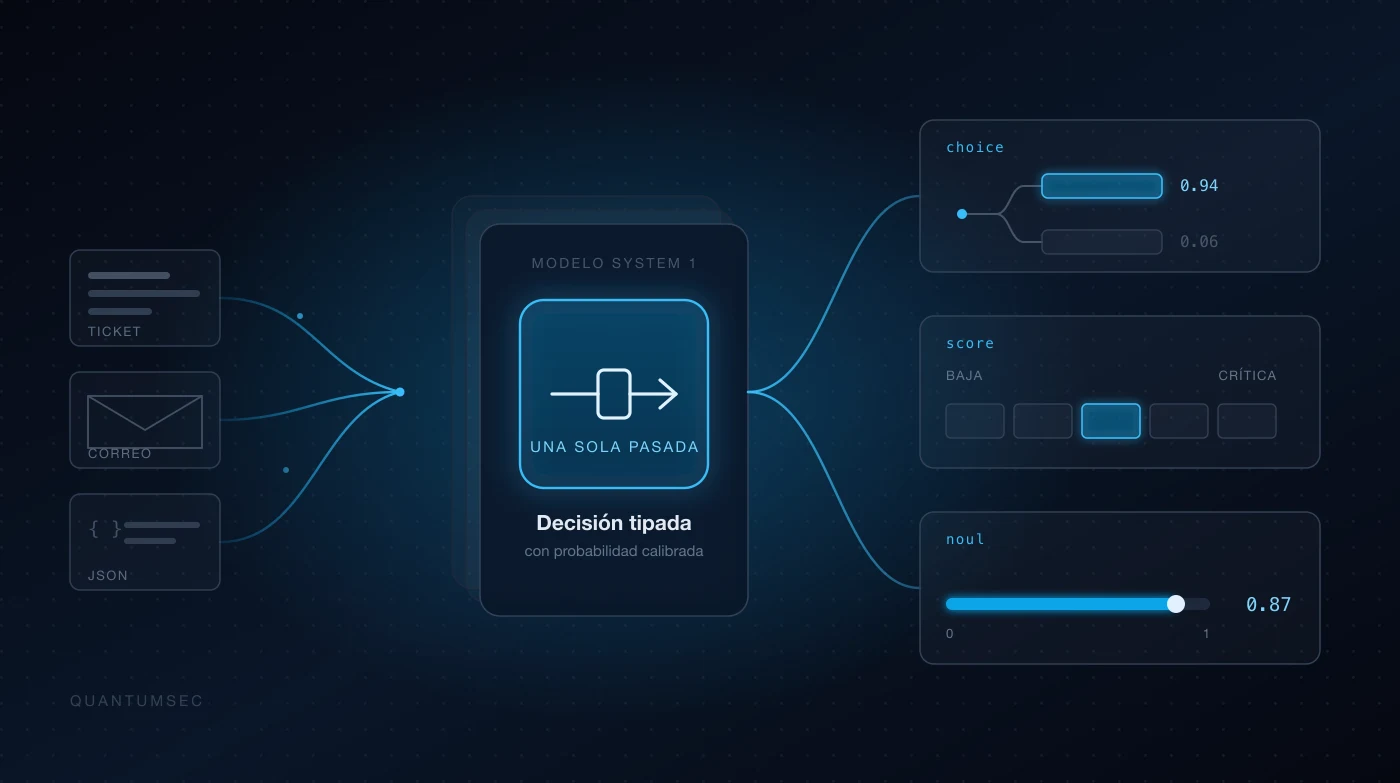
Hay una pregunta incómoda que conviene hacerse antes de leer nada sobre Jev: ¿cuántas de las llamadas que tu empresa hace hoy a un modelo de lenguaje terminan en una respuesta de una sola palabra? Urgente o no urgente. Spam o legítimo. Crítico, alto, medio o bajo. Permitir o bloquear.
Si la respuesta es "muchas", estás pagando por generación de texto para obtener una clasificación. Estás esperando segundos para recibir un token. Y estás aceptando que ese token llegue sin ninguna medida fiable de cuánta confianza merece.
Eso es exactamente lo que Jev ataca. Y como el planteamiento tiene sentido, ha aparecido rápido una alternativa abierta —Laya— que se puede desplegar en tu propia infraestructura. Vale la pena mirar las dos con calma, y también mirar con lupa las cifras que anuncian.
Qué es Jev exactamente
Jev es el primer modelo de lo que TypeSafe AI llama "System One models", en referencia al pensamiento rápido e intuitivo que describe Daniel Kahneman. Lo lanzaron el 15 de septiembre de 2026 tras unos dos años de desarrollo en silencio. La empresa la fundó en 2024 Diogo Almeida, que antes pasó unos cuatro años en OpenAI trabajando en RLHF, InstructGPT, ChatGPT y GPT-4.
La diferencia de fondo es que Jev no genera texto. Recibe una situación descrita y una lista de opciones permitidas, y devuelve una respuesta tipada acompañada de probabilidades y un valor de confianza. Su salida está pensada para que la consuma software, no una persona.
Las tres primitivas
- Clasificar Choice
- Elegir una opción de un conjunto cerrado, hasta 255 opciones. Devuelve la elegida, la probabilidad de cada una y un valor de confianza.
- Ordenar Score
- Puntuar contra niveles ordenados. Devuelve la puntuación y la probabilidad de cada nivel.
- Verificar Noul
- Evaluar si una afirmación es cierta. Devuelve una probabilidad entre 0 y 1.
Todo lo que hace Jev se expresa con estas tres formas. No hay una cuarta que devuelva prosa.
La otra diferencia es arquitectónica: no es autorregresivo. Un modelo de lenguaje produce su respuesta token a token, y cada token depende del anterior. Jev usa un muestreador paralelo que produce toda la salida en una sola pasada. De ahí salen las latencias que anuncia, entre 70 y 500 milisegundos de extremo a extremo.
La pieza que de verdad importa: la calibración
Lo rápido y lo barato son titulares. Lo que hace interesante a Jev para quien trabaja en seguridad es otra cosa, y es el método de entrenamiento: Reinforcement Learning for Calibrated Decisions (RLCD).
Conviene entender el contraste. RLHF —el método con el que se afinan los modelos conversacionales— optimiza para que la respuesta le guste a un evaluador humano. RLCD optimiza para otra cosa distinta: que la probabilidad se corresponda con la realidad.
Qué significa que un modelo esté calibrado. Si el modelo dice 0,9 sobre cien casos, aproximadamente noventa deberían cumplirse. Ni ochenta ni cien. Un modelo que acierta mucho pero cuya confianza no significa nada es inservible para automatizar: no puedes poner un umbral.
Esto es exactamente el problema que tiene cualquiera que haya intentado automatizar triaje con un LLM. El modelo te dice "alta confianza" y no tienes forma de saber qué quiere decir eso. Con un modelo calibrado sí puedes escribir la regla que todo el mundo quiere escribir: por encima de 0,95 se resuelve solo, por debajo va a una persona.
"Cero alucinaciones": el matiz que hay que leer
Es la afirmación que más circula y la que peor se entiende. Conviene decirlo con precisión, porque la diferencia es importante.
Lo que sí garantiza Conformidad de esquema
- La respuesta siempre es una de las opciones que pediste.
- Nunca se inventa una categoría que no está en la lista.
- Nunca devuelve JSON mal formado ni texto donde esperabas un enum.
- No hay que reintentar por formato ni parsear prosa.
Lo que NO garantiza Acierto
- La opción elegida puede ser la equivocada.
- El 0% de alucinaciones no es una cifra empírica de precisión.
- Sigue necesitando evaluación sobre tus propios datos.
- Un error tipado sigue siendo un error.
La propia documentación lo reconoce: "cero alucinaciones" significa coincidencia de esquema garantizada, y la cifra del 0% no es empírica.
Dicho eso, no es poca cosa. Cualquiera que haya montado un pipeline con salida estructurada sobre un LLM conoce el baile de reintentos, validadores y expresiones regulares de rescate. Eliminar esa capa entera tiene valor real, siempre que no se confunda con "el modelo no se equivoca".
Las cifras, y por qué mirarlas con lupa
TypeSafe publica comparativas frente a modelos frontera con números llamativos: entre 20 y 200 veces más rápido, entre 40 y 400 veces más barato. El máximo que reportan son 193,6 veces más rápido y 444,6 veces más barato, contra GPT-5.6 Terra: 0,114 segundos frente a 8,566.
- 70–500 ms
- Latencia de extremo a extremo (Frente a segundos de un LLM)
- 0,042 $
- Por millón de tokens de entrada (Los de salida no se cobran)
- 255
- Opciones máximas en un choice
- 40 M$
- Ronda seed liderada por DCVC (Valoración de 200 M$ según Forbes)
Dos cautelas antes de usar estas cifras en una presentación. Primera: son autoevaluadas. La propia TypeSafe admite que las ganancias reportadas "están en el extremo alto de los resultados del mundo real", y la publicación TechStock² ha cuestionado en concreto la cifra de 445x por ser autoevaluada. Segunda: TypeSafe no ha publicado ni la arquitectura, ni los pesos, ni un paper técnico. Sabemos que es un transformer entrenado exclusivamente con datos sintéticos, y poco más. Algunos observadores externos apuntan a que podría estar construido sobre un LLM de pesos abiertos.
Esto no invalida el producto, pero sí condiciona cómo se adopta. Es una API propietaria de una empresa de dos años. Si la decisión que va a tomar está en la ruta crítica de tu negocio, esa dependencia es parte del análisis de riesgo, no una nota al pie.
Laya: la alternativa que puedes autoalojar
Aquí es donde la historia se pone interesante. Laya, de Convai Innovations, es un modelo de decisión System 1, no autorregresivo y multilingüe, publicado bajo licencia Apache 2.0. Es decir: pesos descargables, uso comercial permitido y despliegue en tu propia infraestructura.
Su planteamiento es el mismo —le das un estado (un texto, un correo, un ticket, un JSON) y preguntas tipadas, y devuelve respuestas tipadas con probabilidades calibradas en una sola pasada— pero la arquitectura sí está publicada.
Las tres variantes
| Variante | Backbone | Parámetros | Contexto |
|---|---|---|---|
| Raíz (inglés) | ModernBERT-large bidireccional | 421 M | 512 tokens |
| Multilingüe | mmBERT-base, más de 100 idiomas | 322 M | 1.024 tokens |
| Typed-decisions | ModernBERT-large | 421 M | 1.024 tokens |
La cabeza de decisión se entrena desde cero: dos capas transformer, un marcador de opciones y una cabeza de escalado. Y el método de entrenamiento es el mismo concepto que el de Jev, también llamado RLCD: la política reporta una distribución, la exploración añade ruido gaussiano de media cero a los logits, y la recompensa usa reglas de puntuación estrictamente propias —logarítmica, esférica, ranked probability score— con actualización REINFORCE al estilo GRPO.
Laya frente a Jev, según los números de Laya
La ficha de Laya publica una comparativa directa contra Jev 1.13.0. Hay que leerla sabiendo de dónde viene —la publica quien hizo Laya, igual que las de Jev las publica TypeSafe— pero es una de las pocas comparaciones públicas que existen.
| Métrica | Laya | Jev 1.13.0 | Gana |
|---|---|---|---|
| typed-decisions | 0,766 | 0,727 | Laya |
| AG News (4 etiquetas) | 0,950 | 0,910 | Laya |
| DAIR Emotion (6 etiquetas) | 0,595 | 0,480 | Laya |
| Banking77 (77 etiquetas) | 0,425 | 0,870 | Jev, y por mucho |
| ECE (error de calibración) | 0,081 | 0,246 | Laya |
| Latencia p50 | 32,8 ms | 236–276 ms | Laya, 6-8× |
La lectura honesta de esa tabla tiene dos partes, y la segunda es la que importa al decidir.
Laya gana en velocidad, en calibración y en los espacios de etiquetas pequeños. En una Tesla T4 —una GPU modesta— resuelve entre 103 y 332 preguntas por segundo en lote, con 32,8 ms de latencia para una sola pregunta. Y su error de calibración es tres veces menor.
Pero pierde estrepitosamente cuando hay muchas etiquetas. En Banking77, con 77 categorías, se queda en 0,425 frente al 0,870 de Jev. Si tu problema es clasificar en un catálogo amplio —tipificar un ticket entre sesenta colas, asignar una vulnerabilidad a una de ochenta categorías CWE— ese número te descarta la opción.
Lo que la propia ficha de Laya admite. Los checkpoints base rinden cerca del azar en typed-decisions zero-shot (0,362). Es floja en preguntas de puntuación ordinal. Y llega sobrecalibrada, así que necesita reajuste de temperatura. La frase que usan sus autores es la que hay que retener: "Laya es una base rápida para especializar, no un motor de decisión zero-shot". De los 51 idiomas que soporta, 45 rinden por encima del azar por un factor de tres.
Cómo elegir entre las dos
Jev API propietaria
- Mejor en catálogos grandes de etiquetas.
- Funciona bien sin afinar nada.
- Coste por token, sin infraestructura que mantener.
- Arquitectura y pesos no publicados.
- El dato sale de tu perímetro.
- Dependencia de un proveedor de dos años.
Laya Apache 2.0, autoalojable
- Mucho más rápida y mejor calibrada.
- Coste de inferencia cero: corre en una T4.
- El dato no sale de tu infraestructura.
- Pesos, arquitectura y método publicados.
- Necesita que la especialices con tus datos.
- Floja con más de veinte etiquetas.
No es una competición con ganador: resuelven el mismo problema con compromisos opuestos.
Si el dato que vas a clasificar es sensible —correos de clientes, tickets con información personal, hallazgos de una auditoría— la conversación cambia de tono. Mandar eso a una API de terceros no es una decisión técnica, es una decisión de cumplimiento, y hay que documentarla en el registro de actividades de tratamiento y valorar la transferencia internacional. Un modelo de 421 millones de parámetros que corre en una GPU modesta y no sale de tu red elimina esa conversación entera.
Qué significa esto para la seguridad
En ciberseguridad, casi todo el trabajo de volumen es clasificación con incertidumbre. Es literalmente el problema que estos modelos resuelven.
- SOC — Triaje de alertas
Un SOC descarta a mano miles de alertas que no aplican. Con una decisión calibrada por alerta a 33 ms, el filtro se ejecuta en línea y el analista recibe solo lo que supera el umbral. - Gestión de vulns — Priorización de vulnerabilidades
Decidir si un hallazgo aplica al entorno, si es duplicado de otro y qué severidad le toca son tres preguntas tipadas. Es exactamente el embudo de triaje que describimos en KOMPLIANCE. - Agentes — Guardarraíles de agentes
Un agente autónomo que va a ejecutar un comando necesita un juez rápido que diga permitir o bloquear con una probabilidad. Un LLM ahí añade segundos y no da un número con el que poner un umbral. - Fuga de datos — Clasificación del dato antes de que salga
Decidir si un texto lleva información sensible antes de que alguien lo pegue en una IA pública. Tiene que ser rápido y local, porque si para comprobarlo hay que mandar el dato fuera, el control no sirve de nada.
Ese último caso es el más elegante, y merece detenerse: un clasificador de datos sensibles que llama a una API externa es una contradicción en sí mismo. Para comprobar si el texto es confidencial, se lo mandas a un tercero. Un modelo autoalojable de 322 M de parámetros resuelve la paradoja.
Cuándo NO usar un modelo de decisión
La parte que no aparece en los anuncios. Hay casos donde esto es la herramienta equivocada.
- Cuando necesitas la explicación, no la decisión. Un informe de auditoría tiene que argumentar por qué algo es crítico. Una probabilidad no argumenta.
- Cuando el espacio de respuestas es abierto. Si no puedes enumerar las opciones, no hay primitiva que lo cubra.
- Cuando el razonamiento en varios pasos es el trabajo. Encadenar deducciones es precisamente lo que un modelo System 1 no hace: por eso se llama así.
- Cuando no tienes con qué evaluarlo. Un modelo calibrado sobre datos que no se parecen a los tuyos está calibrado para otro problema. Sin un conjunto de evaluación propio no sabes si el 0,9 significa algo.
La pregunta útil no es si estos modelos sustituyen a los LLM. Es cuántas de tus llamadas a un LLM nunca necesitaron uno.
Cómo lo estamos mirando nosotros
Nos interesa por una razón concreta y no por la novedad: el triaje es el cuello de botella real de la gestión de vulnerabilidades. Un barrido serio genera miles de hallazgos y la mayor parte del trabajo humano se va en descartar lo que no aplica, agrupar lo repetido y ordenar lo que queda.
Nuestra posición de partida es que el dato no sale del perímetro del cliente, que es también el planteamiento de 0data. Eso inclina la balanza hacia lo autoalojable por defecto, con la limitación asumida de que hay que especializarlo con datos propios y de que los catálogos de etiquetas grandes hoy no funcionan bien.
Y la cautela de fondo, que sirve para cualquier modelo: la decisión automática solo se sostiene si la probabilidad significa algo. Antes de dejar que un umbral cierre hallazgos sin que los mire nadie, hay que medir la calibración sobre los datos propios. Un modelo bien calibrado en un benchmark público puede estar mal calibrado en tu entorno, y ahí el fallo no es ruidoso: es silencioso, y se parece mucho a que todo va bien.
Si estáis valorando meter modelos de decisión en un proceso de seguridad —o simplemente queréis ordenar qué se puede y qué no se puede mandar a una IA—, en QuantumSec trabajamos precisamente esa parte: uso seguro de IA en la empresa, con la política, los controles técnicos y la auditoría del uso real.
Servicio relacionado
implantación de IA segura en la empresa
Temas de este artículo
#Inteligencia-Artificial #Jev #Laya #System-1 #Calibración #Triaje #Agentes-autónomos #Soberanía-del-dato
Seguir leyendo
- ¿Esto puedo subírselo a la IA? Clasifica el dato antes de pegarlo
- Implantar IA en la empresa sin abrir un agujero: control, gobernanza y medición
- KOMPLIANCE: la auditoría que se ve mientras ocurre y la plataforma que se queda después
- Biocomputación Humana: Seguridad e Inteligencia Organoide en la Nueva Era de la IA
- Transformando Sectores con IA, Automatización y Ciberseguridad